Campagne Infolab.
Développer une "culture de la donnée" au service des entreprises et des acteurs du territoire.
Menu secondaire
Blog de Campagne Infolab.
Comment initier une démarche de crowdsourcing relative à un projet ? Par Jérémie Valentin, Amandine Brugière
Par Amandine Brugière le 5 février 2014 Commentaires (2)- 1 - « Crowdsourcing », de quoi parle-t-on ?
La co-production de données par les foules ? Pourquoi - en quoi cela peut-il être intéressant pour un projet, une organisation ? Comment s’y prendre ?
Le crowdsourcing (littéralement “la production de données ou d’informations par les foules”) est un des phénomènes marquants du web2.0, et particulièrement de la dynamique d’Open Data. Il consiste en une mobilisation des compétences ou des connaissances distribuées au sein de la foule. Il peut se développer dans la sphère non-marchande et relative au bien commun : ainsi dans le champ de la santé (sickweather), de la généalogie (Genbecle), de l’alimentation (Open Food Facts), de la cartographie (OpenStreetMap), du handicap (HandiMap), de la recherche scientifique, de la connaissance (Wikipédia) ; mais aussi dans le champ marchand, concurrentiel, voire de l’emploi (mechanical Turk), Humangrid, etc.
Les initiatives de co-production volontaire de données par des individus ou des communautés informelles, ne sont pourtant pas si nombreuses. C’est que le “crowdsourcing” ne se décrète pas : il ne s’impose pas aux foules. ll peut arriver qu’il soit spontané ou non conscient (ReCaptcha), mais il est le plus souvent “incité”. Certaines démarches de co-production n’hésitent d’ailleurs pas à emprunter des biais ludiques (décryptage de l’ADN) ou financiers (Innocentive) pour se rendre attractives.
Quel est le potentiel de coproduction de données d’un projet ? Quelle stratégie mettre en oeuvre pour le favoriser ? Les dispositifs Infolab seront probablement amenés à aider des publics à construire, déployer une démarche de coproduction de données aussi bien pour des publics citoyens que pour des entreprises.
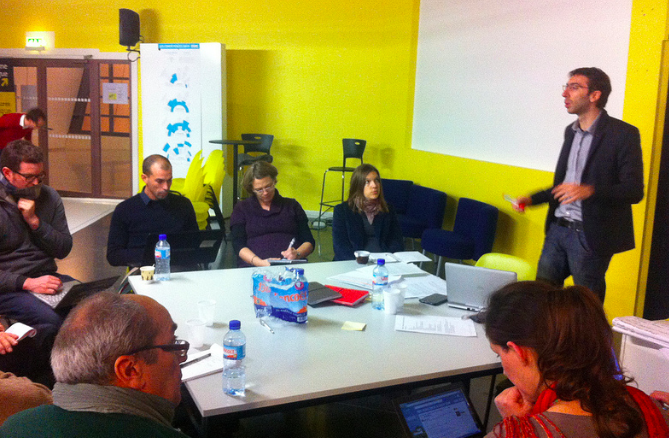
L’atelier proposé le 17 décembre à la Cantine de Rennes consistait à faire vivre une expérience d’évaluation du potentiel de coproduction de données d’un projet, et à élaborer une stratégie adéquate.
- 2 – Cartographier les pratiques maraîchères des habitants de l’agglomération de Rennes : pour quoi faire ?
S’inspirant d’un projet développé par le collectif citoyen Open Data Rennes en 2012, la proposition de l’atelier était de construire une cartographie de la production maraîchère chez les habitants de Rennes et son agglomération. Quelles sont les habitudes en la matière ? Font-ils pousser des fruits, des légumes, des herbes aromatiques, sur leur balcon, dans leur jardin ? Echangent-ils leurs productions ? Existe-t-il des réseaux de partage de denrées locales ?
Un tel projet permettrait par exemple d’évaluer le caractère « vert » d’une ville en prenant en compte les potagers privés ; ou repenser un modèle de développement et d’auto-subsitance d’une population (locavorisme - consommer des produits locaux) ; ou encore travailler à la protection de l’environnement, tout en créant du lien social, etc.
- 3 - DEROULE DE L’ATELIER
Comment réaliser ce projet ? Est-il nécessaire de co-produire des données ? Pour répondre, nous avons suivi la méthodologie élaborée dans le cadre de la campagne Infolab (« parcours d’évaluation du potentiel data pour mon projet »).
a) Quelles données existent déjà sur ce sujet ? « Wanted Data List »
La première étape consiste à créer une liste idéale de données utiles : par exemple l’orthophoto de Rennes Métropole, la liste des jardins familiaux, un annuaire déclaratif des personnes pratiquant le maraîchage privé.
Voici quelques-unes des idées qui sont ressorties de cette première phase de brainstorming.
- Données des associations environnementales
- Données “clients” des AMAP ?
- Enquêtes comportementales, pratiques des ménages
- Données cartographiques du territoire
- Données du cadastre : parcelle, bâti
- Cartographies des espaces verts
- Orthophotographie
- liste des jardins ouvriers, des lieux de cueillettes, des réseaux d’AMAP
- liste des producteurs locaux
- existence de statistiques sur les “grainiers”
- carte des composteurs individuels et collectifs détenus par les Villes qui accompagnent les habitants dans la démarche
b) Evaluation et recherche des données existantes / Prise de contacts avec des producteurs de données
Par la suite chaque élément de cette liste est classé selon son degré de pertinence, et le format envisagé. En effet, il s’agit d’évaluer le potentiel de ré-utilisation de chaque jeu de données. Une donnée de qualité bien renseignée dans un format ouvert et disponible sous une licence permettant sa réutilisation aura un potentiel utile bien plus important qu’une donnée de mauvaise qualité et disponible en pdf par exemple.
Nous avons donc pris le temps d’évaluer, avec les participants, 3 jeux de données via le prisme de leur format, de leur qualité et donc de la faisabilité de leur coproduction collective dans le cas où elles ne répondraient pas à des critères qualitatifs nécessaires à leur réutilisation.
L'orthophoto (open data Rennes Métropole) :
Cette donnée permettrait par exemple, via un traitement de télédétection, de faire ressortir les jardins dans lesquels on pratique du potager privé. En réalité, cela demande certaines compétences et la résolution à 20cm proposée en open data n'est pas suffisante pour identifier ce qui pousse dans un jardin !
Une idée de crowdsourcing serait d'utiliser des drones privés pour prendre des prises de vue aérienne.
Cet exemple radical nous a permis de rappeler que l’utilisation de drone était réglementée…, mais aussi et surtout qu’il devait exister une prise avec une meilleure résolution. Dès lors, contacter le producteur est une piste méthodologique essentielle dans le processus d’évaluation de faisabilité d’une coproduction. Dans beaucoup de cas, la donnée peu renseignée ou absente existe sous d'autres formes chez un acteur proche de la thématique. Il est souvent préférable de passer du temps à négocier une autre version ou bien à faire évoluer les conditions de réutilisation, plutôt que de se lancer dans un montage complexe d’une coproduction de la donnée.
Les jardins familiaux (open data Rennes métropole):
Cette donnée semble revêtir tous les atouts d’une bonne base pour travailler la question des potagers privés. Malheureusement, la donnée manque de renseignement, pas de surface, pas d'adresse, pas de coordonnées géographiques…
Là encore, il est fort probable que des informations supplémentaires existent au sein des collectivités ou des associations. Dans ce cas encore, influer auprès des acteurs concernés reste la priorité avant de se lancer dans une campagne de crowdsourcing. Dans le cas où cette information complémentaire serait réellement absente, il est nécessaire d'associer les collectivités dans la démarche de coproduction, car elles pourraient être intéressées par les données produites pour un usage métier interne.
Ces données collent parfaitement à la thématique, en revanche elles sont disponibles uniquement sous la forme d'un kml (format de données géographiques, propriétaire de Google). De fait, comment extraire ces données et les traiter ? Contacter le producteur originel est une bonne piste, car elle nous a permis d'obtenir les données dans un format exploitable.
Parallèlement, ce dernier exemple a introduit d'autres aspects stratégiques lors de la définition d'une campagne de coproduction de données. Lors de la campagne initiale (collectif open data Rennes), les choix méthodologiques ont été de récolter les informations sur une courte période et sans outil technique de récolte et de mise à jour de la donnée. Une méthode qui permet d’obtenir rapidement des données exploitables, mais qui est insuffisante sur le long terme.
C) Construire une stratégie de coproduction de données
Les suite et fin de l'atelier se sont axées sur les choix stratégiques d'une campagne de coproduction des données. Comment faire pour toucher des réseaux ? Comment publiciser, faire connaître la démarche et inciter les habitants à s’auto-déclarer ? Faut-il monter un événement de lancement de la démarche ? Faut-il animer des réseaux sur le long terme ?Une série de lieux, de réseaux a été alors évoquée :
- les bourses aux échanges de plantes, de graines
- les événements de type “Les incroyables comestibles”
- les maisons de quartier
- les lieux de compostage collectif
- les Lieux de marché
- les grandes surfaces (Jardiland, Truffaut, etc.).
- les jardins ouvriers
Plusieurs pistes comme une stratégie de communication sur le long terme avec des relances trimestrielles, le développement d'outil permettant l'alimentation à tous moments et la formation à des solutions existantes comme OpenStreetMap pour les données géographiques seraient essentielles à la création d'une base de données coproduite. La co-production de données peut aussi développer des approches ludiques pour donner envie de participer et tendre à gommer l’aspect “rébarbatif” de la démarche. Il est même envisageable d’inciter financièrement, rémunérer (à l’instar des projets Mechanical Turk, Humangrid, Designenlassen.de, Wilogo, Innocentive…)
- 4 - LES ENSEIGNEMENTS METHODOLOGIQUES
Un dispositif Infolab doit pouvoir aider des porteurs de projet dans la mise en place d’une démarche de crowdsourcing, en commençant par initier une réflexion sur les données existantes, et sur la pertinence d’une co-production. L’option de crowdsourcing ne peut être considérée comme la « solution clé en main » d’un projet. Il excite plusieurs étapes à respecter et des ressources susceptibles de requalifier les stratégies de coproduction d'une donnée.
Pour récapituler, voici les grandes étapes à prendre en compte :a) Rechercher les données qui existent déjà sur le sujet ? « Wanted Data List »
b) Evaluer la pertinence et prioriser celles-ci
c) Prendre contacts avec des producteurs de données déjà existantes : ils peuvent avoir d’autres choses « en magasin » que ce qui est connu ou publié.
d) Evaluer de la qualité des jeux de données trouvés
f) Définir les données manquantes à co-produire
g) Construire une stratégie - aux moyens diversifiés - de mobilisation des foules
h) S’appuyer sur les réseaux “physiques” déjà existants (ex . assos, marchés, foires) pour faire connaître le projet, trouver des moyens d’incitation à la production (manifestation, publicité, serious game, etc.).
par Jérémie Valentin & Amandine BrugièrePremier Infolab en Gironde et communauté urbaine de Bordeaux
Par Amandine Brugière le 28 janvier 2014Les 21 et 22 janvier se sont tenues les premières sessions d'atelier Infolab sur le territoire girondin et l'agglomération bordelaise. Les villes de Bourg sur Gironde et Cenon accueillaient les participants, venus nombreux (plus de cinquante personnes !) découvrir l'univers des données, et les impacts - actions possibles sur la thématique de l'empreinte écologique.
Retrouvez ici les slides de la journée.
Pour se joindre au groupe de travail, et participer aux prochaines ateliers (le 13 février), veuillez contacter Thierry Marcou !
1er atelier Infolab CUB - CG Gironde : Data - Open Big Small - et thème de l'empreinte écologique from La FingLa Ville et l'agglomération de Rennes, la Cantine rennaise, le LabFab nous accueillaient le 17 décembre pour tenir la 4e rencontre du groupe national.
Une journée remplie de discussions, d'ateliers, de "data", de bricolages numériques et d'innovations ascendantes...
9H30 : L'Infolab, où en est-on ? Que savons-nous ?
11H30 : Visite du LabFab de Rennes
14H30 : Ateliers "Infolab" : Charte, Programmation, Incubation de projets, Crowdsourcing, Dataviz
18H30 : Ouverture de la Cantine Rennaise transformée en Infolab
Retrouvez la présentation ci-dessous, et les photos de la journée :
http:/
/ storify.com/ schignard/ rencontre-infolab-a-rennes Ils en parlent aussi :
Arthur de Logilab http:/
/ www.logilab.org/ blogentry/ 196685 Ben du Master 2 Information-Communication Rennes 2 http:/
/ m2pranet.wordpress.com/ Nous déployons quotidiennement des pratiques personnelles de gestion et d'exploration des données : comprendre un sondage entendu à la radio, lire les résultats d’analyses biomédicales, analyser son relevé de banque en ligne, manipuler une liste de contacts, un fichier de tableur, etc. Ces pratiques reposent sur des savoirs et savoir-faire qui passent souvent inaperçus ou qui ne sont pas suffisamment formalisés. La plus part du temps, ils ne sont pas du tout identifiés, comme le prouvent ces quelques expressions glanées au fil de discussions “Avec Google, j’ai réponse à toutes mes questions”, “Aujourd’hui tout le monde sait se servir d’Excel”, “Une visualisation pertinente, c’est une belle visualisation”, “Je n’ai rien à cacher, pourquoi je le ferais ?”, “Devant une data visualisation, le lecteur n’a pas à lire, il comprend plus vite”...
Or, nous sommes loin d’être tous égaux dans la manipulation des données : dans la compréhension de statistiques, dans la prise en main d’un fichier tableur un peu costaud, dans le bidouillage d’une base de données, dans la compréhension des enjeux... Les compétences requises mêlent à la fois un savoir geek (informatique), expert (statistique), critique (sciences humaines - travailler les corrélations), parfois juridique...
LES COMPETENCES : ENTRE SAVOIRS ET PRATIQUES
Mais, au juste, qu’est-ce qu’une compétence ? Une compétence désigne un savoir mobilisé en situation dans une logique de capacitation. La compétence ne résulte pas seulement de l’expérience ou de la pratique, mais elle émerge de l’activité, c’est-à-dire d’une action concrète et maîtrisée. Ainsi, c’est la qualité d’une activité et du résultat obtenu que désigne cette notion de compétence ; en cela, on peut souligner qu’une compétence n’est pas stable, au contraire, elle évolue au fil du temps et des situations. La compétence fait le lien entre le savoir et la pratique : elle consiste en la mise en situation opérationnelle de connaissances.
Considérant que nous sommes aujourd’hui immergés dans un monde de données (sans en avoir toujours bien conscience d’ailleurs), y a-t-il des compétences minimales requises pour mieux agir au quotidien, assumer sa place de citoyen, être plus efficient au travail ?
Peut-on passer d’une posture - passive - de consommateurs de services à une posture - active - de co-production, manipulation et réutilisation de données ?

Ce sont ces sujets que nous avons explorés collectivement au cours de deux ateliers Infolab (pendant le Connecteur Recherche à Futur en Seine, “Peut-on démocratiser une culture de la donnée”, et pendant l’Open Data Week à Marseille, lors de l’atelier “Les compétences de la “Data Culture”).
Il en est ressorti plusieurs niveaux d’analyses que nous vous livrons ici, détaillant des types de pratiques, et des compétences associées.
NIVEAUX DE PRATIQUE ET CHAMPS DE COMPETENCES
Nous avons identifié, en atelier, 4 niveaux de pratique dans l’expérience quotidienne des données :
- La réception : je lis un sondage, je prends connaissance d’un graphe de données statistiques... Je m’appuie sur la consultation des données pour me faire un avis, pour m’informer ;
- La (ré)utilisation : j’identifie des jeux de données, je sais les récupérer, les manipuler... Je suis en mesure de constituer de nouvelles données par le croisement et l’analyse de l’existant ;
- La production : je sais utiliser les outils pour produire et récupérer des données, les combiner, les structurer, les anonymiser, pour programmer des requêtes, des services... ;
- La diffusion : je documente mes jeux de données, je facilite leurs accès et réutilisation en explicitant les droits de réutilisation (statut juridique, licence), je maîtrise leurs outils de design, de graphisme pour les rendre lisibles et accessibles…
ainsi que 7 champs de compétences mobilisées :
- Lecture-écriture (-> sens critique et culture visuelle),
- Culture numérique (-> maîtrise TIC et machine informatique),
- Information-documentation-communication (-> sens critique et techniques documentaires, stratégies),
- Droit (-> identification du statut juridique des données, des licences liées à la consultation, aux réutilisations)
- Statistique (-> calcul et traitement des données),
- Informatique (-> programmation)
- Design, graphisme (-> mise en forme et lisibilité, ergonomie des interfaces techniques)
1 - LA RECEPTION, les fondamentaux
Culture numérique : “J’ouvre mon navigateur et consulte les actualités”. >>> Maîtriser les bases d’une machine informatique, d’un navigateur, d’une fenêtre de recherche.
Lecture-écriture : “Je trouve les résutats des dernières éléctions présidentielles sur mon moteur de recherche et comprends la carte de France les relatant”. >>> Rédiger des requêtes dans un moteur de recherche associant des mots clés. Trouver l’information pertinente (des tableaux de données, une datavisualisation). Savoir la lire, comprendre les données et mobiliser une culture visuelle.
Information-documentation-communication : “Je me méfie des sondages généralistes et cherche toujours à connaître le panel et les conditions de production du sondage”, “Lorsque je fais mes courses, je décrypte les étiquettes, compare les produits (graisses, sels, additifs, allergènes etc.) et trouve des produits similaires plus sains”. >>> Vérifier la validité et la fiabilité de l'information, à partir d’un sens critique, de la conscience des enjeux, l’analyse des sources. Estimer les risques liés aux modes de production des données (intentionalité, généralisation). Appréhender et exploiter le cycle de vie de l'information.

2 - (RE)UTILISATION, Approche de la construction des données
Culture numérique : “Je sais extraire du logiciel d’inscription en ligne la liste des inscrits à un événement et ouvrir le fichier csv dans un format xls sur mon ordinateur” “Je sais télécharger un jeu de données d’un portail open data et l’ouvrir sur ma machine”. >>> Maîtriser les outils de bureautique courants et les bases techniques de l'information et de la communication (composants matériels, logiciels et services courants, traitement et échange de l'information, caractéristiques techniques, fichiers, documents, structuration de l'espace de travail...).
Information-documentation-communication : “Je comprends l’arborescence thématique d’un portail open data”, “Je m’adresse à une bibliothécaire pour indexer et publier des ressources bibliographiques en format numérique”. >>> Identifier des ressources humaines et techniques. Comprendre la structuration des contenus, les systèmes d’information.
Statistiques : “Je sais calculer des pourcentages”, “j’applique les règles de probabilités à des données pour prévoir la récurrence d’un événement ”, “Je sais réaliser une compression sur un très grand jeu de données en utilisant un algorithme particulier”, “je sais réaliser une inférence statistique pour induire les caractéristiques inconnues d’un jeu de données à partir d’un échantillon représentatif”. >>> Comprendre la nature des données, et savoir les interpréter, explorer les corrélations, les causalités, connaître les règles de probabilités. Extraire des analyses et de l’information nouvelles.
Informatique : “Pour analyser les retours d’une enquête terrain, je crée une récupération automatique des données contenues dans des fichiers tableur qui les agencent dans un fichier maître”. “J’extrais des données d’OSM, je ne garde que les lieux naturels, enlève les dessins vectoriels pour ne plus avoir que les coordonnées GPS d’un point donné.” >>> Nettoyer un jeu de données. Structurer une base de données. Rédiger des requêtes simples.
Droit : “Je comprend que la licence Open Data Base License (ODbL) d’un jeu de données m’autorise à partager, modifier, réutiliser librement les données tout en maintenant ces mêmes libertés pour les autres”, “Quand je réalise une datavisualisation à partir de données ouvertes, je sais que je dois citer les sources des données - noms des producteurs, lien hypertexte vers le site ou le catalogue, et la date de mise à jour”, “je suis un délégataire de service public qui produit des données publiques, mais dont la base de données afférente est soumise au droit d’auteurs, je sais organiser l’accès aux données en conséquence”. >>> Apprécier le statut juridique d'un document numérique, d’une base de données, des droits de réutilisation des données. Comprendre les différentes licences.
Design, graphisme : “Je cherche à produire un rendu visuel des données chiffrées sur la consommation d’eau par régions à la fois de manière fixe (un diagramme), et de manière interactive (les usagers peuvent faire varier un paramètre)”. >>> Maîtrise des outils de graphisme et de visualisation. Former à la représentation. Connaitre la sémiotique visuelle et graphique.

3. PRODUCTION, Manipulation et production des données
Droit : “Je n’autorise pas ce site à accéder, lors de mon inscription, à mes profils publics, ma liste d’amis, mes adresses électroniques et mes anniversaires”, “Je choisis une licence pour les données que je produis et laisse accessible en ligne”
>>> Conditions de production des données : Gérer et maîtriser des données personnelles et stratégiques. Exploiter des données de manière éthique, citoyenne et sécurisée.
Information-documentation-communication : “Je structure mon catalogue de données à la manière d’un thesaurus et documente les méta-données”
>>> Structuration des données : Posséder une rigueur scientifique, assurer la conduite éclairée : documentation (Thesaurus), métadonnées, agencement logique, contextualisation, anonymisation.
Informatique : “J”utilise des techniques de test-itération différentes et complémentaires afin d'atteindre le taux de détection de 95% des anomalies pour assurer un niveau de sécurité “suffisant”, “Une organisation choisit de rendre accessibles ses données uniquement par le biais d’APIs”, “Je crée une interface capable de requêter les données de plusieurs bases de données liées”.
>>> Programmation : Analyser des données (extraction et transformation), Connaitre les modes de transformation des fichiers et des formules : requête, modélisation, test-itération. Bâtir des architectures pérennes.
Statistiques : “Je construis un modèle algorithmique d’apprentissage supervisé, par le biais de boucles de rétroaction, pour cibler les interventions manuelles sur la base”
>>> Traitement élaboré de données (repérage des variables, rédaction d’algorithmes), maîtrise de l’intelligence du système applicatif.
Design, graphisme : “La convivialité de l’interface du portail de données permet à des non-informaticiens de construire visuellement une requête dans la base”, “Nous avons ajouté au portail une couche de datavisualisation interactive”
>>> Représenter l’information, les résultats de requêtes (design de l’information), Construire des interfaces facilitant l’utilisation de la plateforme de données et optimisant l’expérience utilisateur.
4. DIFFUSION, Diffusion des données, câblage de publics clés, marketing de l'information, maîtrise des réutilisations
Informatique : ”Je modifie le code source de mon site pour pouvoir intégrer le code html de google map”, “Je ne donne accès aux données que nous la forme d’API afin de maîtriser les réutilisations”
>>> Design d’interface : Conception de portail, plate-forme. Langage HTML, programmation informatique d’API
Information-documentation-communication : “J’anime mon territoire par le biais de concours, de hackathon qui nécessitent beaucoup de communication locale”, “Le service communication de la collectivité se charge de la communication politique autour de l’ouverture du portail par le biais d’articles dans la presse”, “Les réutilisateurs de nos données peuvent nous signaler des améliorations possibles, corriger et enrichir directement les données, grâce à un système de workflow adapté”
>>> Publicisation, communication politique, constitution et animation de communauté, conception d’un processus d’amélioration continue.
Statistiques : “J’analyse les statistiques de consultation et de téléchargement des différents jeux de données”
>>> Stratégie : Evaluer l’impact économique de la réutilisation données, Produire des données prédictives et prendre des décisions.
Droit : “Selon le type de données mises à disposition, nous avons décliné des licences différentes : ouverte, avec authentication, avec redevance...”
>>> Choix des licences. Protection des données, volonté de maîtrise des usages, ou volonté d’ouverture et de liberté
La complexité des tâches et la diversité des compétences sous-jacentes montrent combien la manipulation de données n’est pas une mince affaire. D’ailleurs elle est majoritairement la chasse gardée des professionnels. Certes, le “learning by doing”, “learning by failing”, le “Do it your self”, chers à la philosophie des bidouilleurs-geeks restent possibles, pertinents, efficaces, comme le prouvent les succès des coding-goûter de Mozilla, l’appétence vis-à-vis des FabLabs.
Mais l’apprentissage par le faire constitue l’une voie d’apprentissage, parmi d’autres, et s’appuie de toutes façons sur les briques de compétences détenues par les individus. “S’exprimer en algorithmes” nécessite des savoirs sous-jacents, vis-à-vis desquels il reste à se questionner sur les modes et les lieux d’apprentissage.
Quels seraient les leviers pour faire montée en compétences un plus grand nombre d’acteurs et de citoyens dans cet univers des données et des algorithmes ? Comment spécifier les compétences en fonction des modes de formation ?
Entre formation initiale, formation continue et diplômante, espaces de médiation, dispositifs d’éducation populaire, les modes d’apprentissage pourraient se réaliser différemment.
Par Faustine Bougro, Sarah Labelle, Amandine Brugière
RMQ : Merci aux participants des différents ateliers pour leurs apports et points de vue critiques affûtés ! Continuez à réagir et commenter, cela constitue la base des réflexions à venir, à mener collectivement. Prochain rendez-vous 20 septembre à Bordeaux.
Retrouvez l'infographie globale
Invitation à la 4e rencontre du groupe national Infolab à Rennes le 17 décembre
Par Amandine Brugière le 21 novembre 2013
Bonjour à tous,
Nous avons le plaisir de vous inviter à la 4e rencontre du groupe national Infolab, qui se tiendra à Rennes le mardi 17 décembre prochain de 9h30 à 21h à la Cantine numérique rennaise, 46 boulevard Magenta à Rennes (35).
Après les rencontres de Paris, Marseille et Bordeaux, nous vous proposons de mettre en pratique les premiers enseignements de la campagne et de prototyper un Infolab grandeur nature, qui sera matérialisé et ouvert au public le soir de notre rencontre.
La journée se déroulera en trois parties :
1. La matinée : D’un Lab à l’autre, Infolab et LabFab
9h30: Accueil-café à la Cantine numérique rennaise
10h: Que sait-on de l’Infolab ? Présentation d’un bilan d’étape par l’équipe Infolab
11h: Transfert vers le LabFab de Rennes
11h30 - 14h: Présentation du LabFab et pause déjeuner in situ (sur inscription)2. L’après-midi : Faire l’Infolab (ateliers pratiques)
De 14h30 à 18h, nous vous proposons d’assister à 2 ateliers d’1h30 chacun, à choisir parmi les thèmes suivants:
- Représenter et visualiser des données,
- Collecter, saisir, nettoyer des données en mode crowdsourcing,
- Incuber un projet « Data » : de l’idée au prototype,
- Définir la charte et la programmation possibles d’un InfolabLes ateliers pratiques sont proposés dans une optique réflexive et font la part belle à des méthodologies clé en main, conçues et documentées dans le cadre de la Campagne.
3. Le soir : l’Infolab ouvre ses portes !
De 18h30 à 21h30, l’Infolab ouvre ses portes au public !
La Cantine numérique rennaise se transforme, le temps d’une soirée, en un premier prototype d’Infolab ouvert au public. Au programme de cette soirée, la présentation de plusieurs pôles d’un possible Infolab: “DataViz” (représentation des données et lecture critique), “Projet Data” (parcours d’accompagnement et d'incubation des projets), “Ils produisent de la donnée” (démonstration d’objets connectés), … Mais aussi beaucoup d’autres choses à découvrir et à construire...Les places sont limitées, merci de vous inscrire en précisant les moments de la journée auxquels vous souhaitez participer.
Au plaisir de vous retrouver le 17 décembre,
L'équipe Infolab
Organisations invitées : Alcatel-Lucent, l'ANACT, Aquitaine Europe Communication (AEC), les Arpenteurs, Arsenic, l'Association Les Petits Débrouillards, l'Association Pénombre, la Caisse des dépôts et consignations (CDC), le cabinet Chronos, les Communautés urbaines de Bordeaux (CUB), de Rennes (Rennes Metropole), de Nantes (Nantes Métropole), et de Lyon (Grand Lyon), les Conseils généraux de la Gironde, de Loire-Atlantique, de la Manche, de la Saône-et-Loire, la CNIL, les collectifs Open Data de Rennes - Tours - Poitiers, Créatif, Data Publica, Décider ensemble, le CRIJ Poitou-Charentes, Etalab, le Groupement français des industries de l'information (GFII), Gemalto, INRIA, l'Institut de la Méditerranée, la Fonderie, le groupe La Poste, Libertic, Logilab, Mediagraph, l'OpenKnowledgeFondation France, OpenDataSoft, OpenStreetMap, Orange Labs, QUNB, Regards citoyens, la Région Ile-de-France, la Région Pays-de-la-Loire, la Région PACA, Silicon Sentier, Solidatech-Ateliers du Bocage, Suez Environnement, l'Université de Paris 13, les Villes de Montpellier et Paris, VisualDecision.fr, Without Model, et les Grands partenaires et adhérents de la Fing.
La campagne Infolab lancée en avril 2013 entend développer une culture des données au services des acteurs et des entreprises des territoires. Elle est soutenue par les partenaires suivants :

Quelle culture des données pour des outils décisionnels performants ?
Par Amandine Brugière le 19 novembre 2013Aujourd’hui, collectivités, entreprises, associations et individus peuvent disposer à moindre coût d’outils d’aide à la décision et de fouille de données pour optimiser leur gestion, campagne de communication, évaluation de performance... Un panel de différents outils décisionnels contribue à changer les pratiques, les métiers et à créer de nouvelles tensions. L'objectif de l'atelier Infolab du 27 juin lors de l'Open Data Week Marseille, était de se pencher sur le rôle que les données peuvent jouer dans le domaine décisionnel et les approches décisionnelles.
Les interventions de collectivités: Thomas Eisinger (Région Provence-Alpes-Côte d'Azur) et d'associations : Hervé Paris (AlterCarto) ont permis de réaliser un état des lieux et une remise en perspective des outils decisionnels et de leur évolution du fait de l’émergence des données.
L'usage des données est à la base du développement d'indicateurs, d'outils de simulations, d'infographie et « datavisualisations », etc. Autant d'outils décisionnels pour mieux gérer, prévoir et optimiser ressources et stratégies des organisations. Si les outils d'aide à la décision semblaient jusqu'alors réservés aux grandes entreprises et administrations, aujourd'hui tableaux de bord et autres outils d'enregistrement et d'analyse de données sont consultés, produits et alimentés par tout un chacun.
Dans les jeux vidéo, en particulier ceux de stratégies (par exemple les city builders), les « gamers » doivent gérer intelligemment leurs tableaux comportant de multiples indicateurs, pour pouvoir progresser. Dans la vie quotidienne, les exemples de personnes qui trouvent dans la mesure de paramètres biomédicaux (santé, sport) un moyen d'avoir prise sur leur angoisse (comme ces parents) ou d'améliorer leur hygiène de vie (comme le raconte Emmanuel Gadenne) se multiplient. Les outils de traçage, de management des données deviennent monnaie courante et peuvent être utilisés par le plus grand nombre (comme Klout, Graph Search...).
Cependant, les modes de calcul et la nature des résultats ne sont pas forcément explicites et accessibles.
Historiquement, ce sont les administrations qui ont créé des outils de classement qui permettaient de rationaliser l'accès à l'information, de structurer les données pour mieux prévoir et mieux définir leurs actions. Avec le web des données, le nombre de données à traiter augmente, les modalités de calcul se diversifient, se complexifient. L'accès d'un plus grand nombre de personnes à ce nouvel indice qu'est la donnée modifie sans aucun doute la manière dont des décisions sont prises.
Qu'est-ce qui se transforme exactement ? Qu'est-ce que ces nouvelles « métrologies » offrent comme nouvelles possibilités ? Qu'est-ce qu'elles rendent plus visible, lisible, ou au contraire, qu'elles permettent d'évacuer ?
L'aide à la décision, telle qu'elle est développée dans le champ de la « Business Intelligence » ou la statistique publique, est une activité qui mobilise plusieurs acteurs : elle se fonde sur le choix d'informations qui permettent de répondre à des questions posées, qu'elles soient d'ordre prospectif ou analytique. Notons que les acteurs impliqués doivent échanger et déterminer ensemble les objectifs du processus de décision. Dans ce processus, le choix des données et des informations est donc crucial, tout comme le seront les outils mobilisés.
Il s'agissait donc, à travers cet atelier, de confronter plusieurs champs d'aide à la décision : une grande entreprise ayant recours au service du BI, le service de contrôle de gestion d'une grande collectivité, une démarche de consultation publique des citoyens...
Ces différentes interventions ont mis en évidence plusieurs problématiques:
-
D'une part, l'accessibilité large des données et l'élargissement des dynamiques de « data-driving » questionnent non seulement la manière dont les décisions sont prises, mais aussi la manière dont les métiers et les compétences individuelles sont amenées à évoluer. L'usage de MailChimp par l'équipe de la Cantine de Rennes est une excellente illustration de la professionnalisation marketing de l'équipe associative. Ou encore la démarche de mécénat d'outils de gestion de données pour les associations, et les formations associées, animés par les Ateliers du Bocage - SolidaTech / Emmaüs France, en lien avec SAP .
-
La présentation d'Hervé Paris portait sur une plate-forme de données cartographiques sur la santé et sur le territoire de Lyon. Plusieurs actions ont été menées parallèlement : l'équipement de différents services d'outils statistiques territorialisés, la mise en place d'ateliers de débat. L'usage de cette plate-forme visait à ce que les données deviennent des instruments de dialogue entre les services et d'implication des citoyens et des associations dans les processus de décision. L'enjeu est à la fois citoyen et décisionnel : est-ce que l'usage des données peut renouveler la manière de fabriquer les politiques publiques ? L'enjeu est que les espaces de décision soient fermés. Au contraire, par l'accès aux données, il devient possible de redistribuer la parole et de redessiner les processus de décision.
-
Également, la nature des outils mobilisés joue un rôle déterminant dans l'interprétation des données collectées et mobilisées, cela influence les conditions du débat. Les outils utilisés ne sont pas dénués de « visions stratégiques » (de considérations sur la manière dont on manipule au mieux des données à des fins décisionnelles). Quelle est la marge de liberté laissée aux acteurs qui les utilisent ? Les outils sont-ils « boîte noire », c'est-à-dire des machines à calculer dont il est difficile de comprendre les équations ou les modèles qui arrangent et redistribuent les données?
Par Sarah Labelle et Claire Gallon
Des Infolabs : pour développer une culture des données / Infolabs: FOSTERING OPEN DATA CULTURE
Par Amandine Brugière le 3 juillet 2013Les données – et particulièrement les données ouvertes, ou personnelles - constituent des sujets de plus en plus médiatisés (=dont la presse parle).
- C’est la 3e édition de l’ODW en France.
- Chaque année, de nouvelles collectivités ouvrent leurs données, des collectifs citoyens émergent dans les villes de France,
- Des ateliers hackathon, cartopartie, scrapathon, openbidouille, codinglunch, coding weekend se multiplient…
Malgré cela, chaque année, nous faisons le constat que les datas sont un sujet de geeks qui restent entre les mains des geeks. Qu’est-ce que cela traduit ?
1) Savoir manipuler des données reste un exercice difficile :
/// Cela nécessite une certaine culture des données et de compétences techniques :
- développement informatique (manipulation d’une base de données)
- de connaissances statistiques (règles d’analyse de grosses quantités de données)
- des connaissances algorithmiques
- voire ensuite d’infographie.
Notons aussi, que le plus souvent, les réutilisateurs de données travaillent en équipe, en collectifs : outre le besoin de compétences techniques, c’est le besoin de partager les points de vue, les analyses, de construire collectivement le sens à extraire des données.
/// Cela nécessite aussi une conscience du « pouvoir » des données
Conscience de l’existence de données (données personnelles, données publiques ouvertes, données crowdsourcées) et des enjeux sous-jacents (politiques, économiques) ; et conscience des connaissances nouvelles que leur traitement peut faire naître.
2) les solutions
La solution la plus simple serait que nous devenions rapidement « tous geeks ». Cela passe par le développement de l’enseignement du code, des mathématiques, de l’algorithmique, de la statistique à l’école. Ce type de réflexions gagne du terrain. La Ministre française Fleur Pellerin l’a évoqué récemment. Mais concédons que cela peut prendre un certain temps : une à deux générations.
Une deuxième solution serait que l’accès à des ressources « outils » mais surtout « ressources humaines » soit facilité. Il existe aujourd’hui beaucoup d’outils en ligne – accessibles gratuitement (je vous renvoie au recensement que nous avons commencé dans le cadre de la campagne Infolab), mais qui sont tous d’un niveau d’usage difficile.
En dehors de quelques start-up big data, et des moments collectifs de type hackathon, il n’existe pas de ressources humaines, de compétences accessibles. En France, 1, 2, peut-être 3 espaces publics numériques commencent à proposer des formations dans ce sens. Mais rien d’autre.
3) La Campagne Infolab
La FING a lancé en avril une « campagne » (like recherche-action / R&D) Infolab : en partenariat avec plusieurs collectivités territoriales (Région Paca, les agglomérations de Rennes et Bordeaux, le département de Gironde, la Ville de Paris), l’Etat (Etalab), l’INRIA – organisme de recherches, l’Université Paris 13, les groupes Alcatel-Lucent, la Poste, l’association OKFN
Le terme Infolab reprend volontairement la métaphore des FabLab : est-ce qu’il est envisageable et « utile » de développer des espaces de bidouilles de la donnée ?
Quelle autre forme de médiation / intermédiation faut-il développer pour sensibiliser et accompagner un plus grand nombre de public dans la manipulation de données ? entreprises, associations, organismes publiques, citoyens.
C’est la question que l’on se pose au sein d’un groupe de travail inter-territorial, et à travers des expérimentations terrain.
A ce stade des réflexions on ne sait pas encore au sein de quel type de structures des infolab pourraient voir le jour (ni comment cela pourrait être financé), mais nous identifions déjà plusieurs missions à remplir :
- Développer des formations « techniques » aux outils existants, et pourquoi pas, de la sensibilisation aux sciences algorithmiques et statiques ;
- Développer de l’« éducation populaire » (un terme consacré en France : il existe une tradition d’éducation populaire – centres culturels et sociaux, etc.), : sensibilisation et dialogue avec les citoyens autour des enjeux politiques et économiques des données ;
- Développer des dispositifs d’incubation et d’accompagnement de projets à base de data à des coûts accessibles aux petites structures – entreprise, associations – ou aux petits collectifs ;
- Stimuler les usages de co-production de données : de production collective de données, car les données publiques ouvertes ne suffiront pas. On le voit par exemple dans le domaine du développement durable ;
- Proposer des espaces libres ouverts à la « bidouille », et équipés d’outils et de compétences adéquates ;
- On peut même imaginer que des infolabs accompagnent des démarches de concertation publique (aménagement urbain), de démocratie participative.
Cela commence à mettre en lumière le besoin de métier nouveau : data-scientist, data-artisan, data-community manager… ?
Les Infolabs nous apparaissent utiles en particulier dans leur dimension collective :
- les données en appellent au développement d’une culture de la collaboration (apprendre à faire avec : d’autres compétences, d’autres données que les siennes).
- Elles en appellent aussi – paradoxalement - au développement d’un sens critique vis-à-vis de la quantification du monde : les données ne sont pas toujours synonyme d’objectivité, de rigueur et d’impartialité. Or c’est dans la mise en discussion des données que cela se révèle.
Concevoir des espaces de co-élaboration du sens, favoriser les usages collectifs des données, développer une culture des données voilà la mission des Infolab. Les – futurs - Infolabs seront d’autant plus nécessaires que les usages prédictifs des données se développeront. L’avenir se construit à plusieurs.
Nous vous invitons à vous joindre aux deux ateliers Infolab qui se tiendront demain : le matin sur le thème des approches décisionnelles, l’après-midi sur le thème des compétences.
//////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////////
Data – especially open or personal data – has become quite a hot topic in the media.
- This is the third annual ODW here in France;
- each year more and more local governments are opening up their data;
- while, across France, citizen data collectives continue to emerge; and
- the number of hackathons, data scrapathons, coding lunches, mapping weekends, coding weekends and open DIY workshops continues to grow.
Despite this momentum, data remains ‘geek-specific’. What does this imply?
1) Wrangling data is still challenging.
>> Data wrangling requires a specific technical skill set, and a certain degree of data-related knowledge:
- IT development skills (for database manipulation)
- Some understanding of statistics (the rules for large-scale data analysis)
- A basic familiarity with algorithms
- even some graphic design skills
It is also interesting to note that, usually, data re-users work in teams or as collectives: so apart from the need to share technical expertise, viewpoints and analyses must also be shared, and the meaning extracted from the data is therefore also collectively constructed.
>> This requires that data re-users have an informed sense of the “power” of data
An awareness of the existence of data (personal data, open public data, crowdsourced data) and the underlying issues surrounding it (political, economic); plus an awareness of the range of new knowledge data manipulation may give rise to.
2) Solutions
The simplest solution would be for us all to become “geeks” as soon as possible. This could be achieved by adding coding, maths, algorithm and statistics courses to school curricula: an idea that is gaining some traction. In fact, French Minister Fleur Pellerin actually mentioned this very notion recently.
Realistically, this level of implementation would take 1-2 generations to bear fruit.
Another solution would be to facilitate public access to the necessary tools and resources, and especially “human resources”. There are already many freely available, online tools (have a look at the overview published during our Infolab campaign), but these are all relatively difficult to use. Apart from a few big data startups, and collective efforts like hackathons, no actual human expertise is currently available. There are only maybe 3 public digital centres in France that have begun to offer training of this nature – but that is all.
3) The Infolab Campaign
In April, FING initiated an Infolab action research campaign, in partnership with a number of local authorities (Region Paca agglomerations, Rennes and Bordeaux, the department of Gironde, the City of Paris), the State (Etalab), the INRIA - research organization, the University of Paris 13, Alcatel-Lucent, the French National Post office, and OKFN.
The term Infolab intentionally adopts the FabLab metaphor: is it possible and is it "useful" to develop publicly accessible “DIY data” spaces?
What other forms of mediation/intermediation should be developed to educate and support the data manipulation efforts of the general public?
companies, civil society organisations, government agencies, citizens.
We are investigating these questions within an inter-territorial workgroup, and through field experiments.
At this stage, we have yet to identify the organisational structure that could best support the emergence of Infolabs (nor how they might be financed), but we have already identified several tasks they should perform:
- Develop "technical" training for existing tools, and (why not?) teach the fundamentals of algorithms and statistics;
- Develop France’s "popular education" (popular here means “of the people”, a notion that implies the education of the general population via social and cultural community centres): which means awareness-raising and dialogue with citizens about the political and economic issues surrounding data and its manipulation;
- Develop platforms for the incubation and support of data-based projects led by smaller organisations–small businesses, civil society organisations– or small collectives;
- Stimulate the development and use of co-produced data: especially the collective production of data, as public open data has its limitations. This approach has been adopted in the field of sustainable development, for example;
- Offer free, open "hack" spaces, equipped with adequate tools and staffed with individuals holding the right sets of skills;
- Infolabs could even act as vectors for public consultations (urban development), and a participatory democracy.
These ideas highlight the need for a new class of professionals: call them data-scientists, data-artisans, community data managers… ?
To us, Infolabs seem especially useful in terms of their collective aspect:
- Data wrangling calls for the development of a collaborative culture (learning by doing, with “others”: other skills, data other than what is personal, other people).
- It also – paradoxically – calls for the development of a critical perspective on the quantification of our world: data is not always synonymous with objectivity, thoroughness and impartiality. When data is discussed in a group setting, its ambiguous nature is revealed.
The aim of the Infolabs campaign is to create spaces that foster the collaborative uses of data, where meaning can be co-created, and where data culture can be developed and expanded. The - future - Infolabs will be all the more necessary as more uses for predictive data are developed. The future will be built by many.
We invite you to join us for the two Infolab workshops taking place tomorrow: the morning session deals with decision-making approaches, and during the afternoon session we will focus on skills.
"Partenaires, à vous la parole !", entretien avec Sébastien Keiff.
Par Faustine Bougro le 12 juin 2013
Dans le cadre de la Campagne Infolab, la FING propose une série de portraits de ses partenaires, oeuvrant pour le développement d’une culture et d’une médiation à la donnée. Ils sauront inspirer, par leurs visions stratégiques, de futurs champs d’action de l’Infolab. Nous avons choisi d'ouvrir ces entretiens avec Sébastien Keiff, chargé de mission Agenda 21 au Conseil Général de la Gironde (33).
FING : Pour toi, qu'est-ce qu’une donnée et que représente t-elle ?
S.K : Au départ, je n’étais pas investi au sein du projet d’Open Data au département. Pourtant, j’ai une formation d’économiste qui aurait pu m’attirer vers ce sujet bien plus rapidement. J’ai toujours, tout au long de ma carrière professionnelle, été amené à manier de la statistique à différentes échelles. De près ou de loin, lorsque nous conduisons une démarche de développement durable, parce que c’est vraiment mon coeur de métier, nous avons une phase assez importante d’observation du territoire.Cette observation, elle se fait en général avec deux clés d’entrée. La première clé est dite « quantitative ». Il nous faut de la donnée et de la statistique pour pouvoir exposer les phénomènes en présence sur le territoire au regard du développement durable. Il y a une autre dimension, beaucoup plus « qualitative », qui est de l’ordre du rapprochement et du dialogue avec les citoyens. Par exemple, s’il y a 4% de chômage sur un territoire, je peux conclure qu’il n’y a aucun problème d’emploi sauf qu’en réalité, il n’y a plus non plus d’actif ! On peut donc discuter avec les citoyens, leur présenter une situation et leur demander “mais est-ce que vous le ressentez de la même manière sur le territoire ?” De fait, on découvre des perceptions, ni plus justes ni plus fausses que la statistique en elle-même, et ça rend toute la donnée plus objective. La donnée pour nous, c’est donc une ressource qui nous permet d’alimenter une certaine vision en présence sur un territoire.
FING : Pourquoi est-ce important pour toi de travailler avec des données?
S.K : Je suis au département depuis maintenant 5 ans, et lorsque j’ai rencontré mon collègue Pascal Romain (chef de projet sur l’Open Data), nous nous sommes croisés assez rapidement autour de l’idée d'une transition sociétale vers un monde plus durable. Nous nous sommes rendu compte que nous avions besoin de données et besoin d’un dialogue avec les citoyens pour travailler ensemble. L’Open Data a alors pris tout son sens pour moi, non pas comme finalité, mais comme outil et ressource au service d’un projet territorial de développement durable.
FING : Quelles sont les données que vous utilisez dans le cadre de l’Agenda 21 ? Quelle place occupent-elles dans votre organisation ? Êtes-vous producteur, réutilisateur, médiateur de données ?
S.K : J’identifie les indicateurs nécessaires à l'observation stratégique et pertinente des dynamiques territoriales. Qu'elle est la dynamique associative? Comment se noue le lien social ? Comment se fait l’épanouissement des êtres humains ? Quelles sont les vulnérabilités du territoire face aux aléas climatiques? Pour tout cela, j’ai des presentiments à l’échelle du territoire, mais quelles sont les données qui vont me permettre de les justifier ? Je m’appuie principalement sur des données extérieures que peuvent récupérer des acteurs constitués, qu’ils soient des collectivités, des observatoires, des corps de l’état, ou des associations. Je construis une sorte de légitimité dans l’observation et me demande ensuite ce que ces données disent de mon territoire. Je suis alors apte à mesurer ma stratégie ou mes dynamiques locales.
Il y a une autre dimension dans notre production de données, sur des dynamiques particulières en Gironde. Par exemple, nous géo-référencons toutes les initiatives liées au développement durable. Pour tout cela, nous avons eu besoin de produire des données, des tableurs et c'est là que nous avons commencé à nous frotter à la production de données. Avant dans mes tableurs, je renseignais le nom de la commune et je n'avais jamais réfléchit au fait que sans l’indication du code postal, il me serait impossible d’arriver à trier mes données. Donc nous apprenons petit à petit...
FING : Qui est sensible à cette démarche d'Open Data dans l’Agenda 21 ?
S.K : Pascal Romain a déjà largement constitué toute une communauté derrière l’open data. Mais je constate qu’aujourd’hui, il faut encore prendre son bâton de pèlerin pour aller parler à des collègues, un par un. Au delà de l’obligation légale qu’il pourrait y avoir, pour l’instant personne n’est réellement enthousiaste.L’Open Data n’est pas une finalité, c'est ce qui nous permettra d’atteindre des objectifs partagés et c’est sur ce point qu’il faut argumenter. Soit nous y allons un par un pour demander les mêmes données, soit nous mutualisons, nous mettons en commun, nous les rendons plus fortes en étant plus à les utiliser, à les mettre à jours, etc., et c’est là que le portail Open Data peut jouer son rôle, plein et entier.
FING : Quels sont pour toi les freins juridiques, économiques, etc., au développement de l’Open Data ? Te sens-tu acteur du changement ?
S.K : J’ai identifié plusieurs freins, il y a d'abord la notion de vocabulaire sur à peu près tous les champs thématiques. Quand j’ai construit mon Agenda 21, j’ai appris la définition des mots utilisés au quotidien. J'ai également appris à les redéfinir, et sans cet effort, je risquais dans le dialogue de me heurter à un mur.
Il persiste un autre frein majeur avec les collectivités qui produisent de la donnée. Aujourd’hui, je construis mon tableur Excel pour moi. J’ai donc fait ma “tambouille”, je l'ai complété au fur et à mesure, j’y ai rajouté des onglets et je m’y retrouve. Mais si je suis amené à le rendre public, c’est autre chose. Ce processus d'ouverture demande une refonte d’un tableur construit depuis parfois cinq ans, je n'en ai pas forcément l'envie et en cela, c’est un frein. L’information, il faut réussir à la transformer en connaissance, mais partager c’est aussi donner du pouvoir aux autres... Au sein de nos cultures administratives, nous n’avons jamais partager la donnée, au contraire, nous la centralisons. A t-on envie d’anticiper, de construire un discours, ou au contraire de co-produire des argumentations, des avis ?
FING : Quels outils, méthodologies, etc., vous seraient profitables pour démocratiser et développer une culture de la donnée en interne ?
S.K : Prenons un exemple : je suis chargé de mission et je souhaite aller parler de l’Infolab avec un élu, j’ai 5 mn sans même avoir le droit de rentrer dans son bureau, comment l’interpeller ? J'imagine de là un petit kit de l’Infolab, au sein duquel je pourrais saisir à la carte des éléments facilitant cette démarche. Il pourrait y avoir des éléments de vocabulaire accrocheurs et, quitte même à être encore plus à la carte, une entrée par acteur. A quel acteur je m'adresse : une entreprise très nationale, des techniciens ou des élus, etc. ?Je pense que nous n’aurons pas d’autres choix que d’avoir un certain nombre d’outils. Le portail data local sera un outil qui a lui seul ne suffira pas. Comment peut-on sortir de la communauté des utilisateurs geeks, et construire ensemble une culture de la donnée autour d’un lieu ressource, qu’il soit numérique ou physique, de médiation de la donnée ?
FING : Pourrais-tu nous en dire un peu plus sur ton projet de “Bourse aux compétences” ?
S.K : C’est un projet européen monté en 2009 autour de notre réseau d'acteurs. Nous sommes 63 collectivités, donc 63 collègues à travailler de manière assez proche pour favoriser le développement durable de notre territoire, mais tout cet écosystème est basé sur un réseau humain. De fait, à chaque départ, nous recommençons à zéro.Nous avons donc, en premier temps essayé, de définir une compétence de développement durable. Ensuite, l'idée a été : comment pourrait-on avoir une sorte de base de données intelligente que nous pourrions interroger ? Nous perdions ce côté très humain qui en faisait la richesse mais aussi toute la fragilité pour un format plus pérenne.
Olivier Chator, qui effectue une thèse en cognitique au sein du Conseil général, a alors formalisé un système multi-agents permettant la mise en relation d'une offre et d'une demande de compétence que je souhaite partager. Nous sommes pour l'instant sur le développement durable et je n’ai aucune barrière au fait d’agréger d’autres champs thématiques, d’autres compétences.
FING : Quels rêves nourissent votre ambition pour une culture de la donnée ?
S.K : Nous portons deux projets, qui apparaissent lointains, mais qui à mon sens restent forts. Le premier se base sur l'idée que nous nous concentrons beaucoup autour du crowdsourcing et des données descendantes mais que nous ne pensons pas assez l’aspect intermédiation. Je ne crois pas aux données purement citoyennes ou institutionnelles mais il y a, pour moi, un ensemble à construire, ce que moi j’appelle de la mutualisation autour des données. C’est à dire, j’aimerais ne plus trouver d’un côté l’application permettant d’identifier les crevasses sur les routes et de l’autre, la publication de cartes routières du département, mais un dispositif m’indiquant comment bien circuler dans le département. Il va falloir que nous organisions un écosystème qui fasse un peu plus société et de fait, que nous construisions de la concertation autour de la donnée.
Le deuxième projet, c’est un champ traitant la notion de co-responsabilité sociétale. Concrètement, sur les dynamiques de territoire, nous ne sommes pas les seules en présence. Le changement climatique personne n’y peut rien tout seul et en même temps tout le monde y peut quelque chose mais une fois dit, cela n’engage pas beaucoup plus. Et si nous allions jusqu’à dire de combien nous sommes responsable. Ma responsabilité est peut-être infinitésimale mais elle y est. En Gironde, il y a tant de multinationales, tant de citoyens, tant de TPE, etc., nous avons tous une implication sur le changement climatique et maintenant, comment ensemble nous faisons notre part ? Cela va demander une mise en commun de la donné. J’aimerais bien y arriver par la question de la médiation de la donnée pour construire une culture de la réponse, à des enjeux territoriaux.Entretien réalisé par Faustine Bougro et Loup Cellard.
Les 13 et 14 juin prochain, à l’occasion du festival Futur en Seine, la Fing organise avec Inria le “Connecteur Recherche”, format d’échanges entre chercheurs et praticiens, autour de 6 sessions thématiques dont l'infolab le vendredi 14 juin de 10h à 12h.
Pendant deux heures, vous serez à la fois auditeur et contributeur. Et après les ateliers, vous pourrez retrouver des synthèses de tous les échanges en libre accès sur le réseau social de la Fing.
Objectif : Du frottement entre chercheurs et acteurs, pour provoquer des mises en relation fertiles !
- porter à la connaissance des acteurs les travaux de recherche les plus éclairants
- apporter aux chercheurs des “questions de recherche” issues de la prospective et des acteurs professionnel
Amandine Brugière animera la session Infolab de 10h à 12h sur le thème: Peut-on démocratiser une culture de la donnée ? Le “déluge” de données que les outils et services numériques occasionnent questionne les capacités des individus à “exploiter”/”tirer profit” de ces données par eux-mêmes. Aujourd’hui cette exploitation est essentiellement le fait d’experts qui disposent des connaissances et des outils requis. Existe-t-il une “culture de la donnée” ? Et celle-ci pourrait-elle être démocratisée ? Quelles seraient les composantes d’une “data-literacy” (alphabétisation / éducation) ?
Ils viendront, avec d'autres, échanger sur leurs expériences :
- Frédérique Pain, Bell Labs
- Pierre Valarcher, Université Paris-Est
- Henri Verdier, Directeur d'Etalab
- Vincent Blanchard, Responsable du programme AdB-SolidaTech aux Ateliers du Bocage
- Gustavo Gomez Mejia, sciences de l'information et de la communication, Gripic - Celsa
Où:Au CENTQUATRE
Écurie E
5 rue Curial
Paris (19e arr.)« Adhérents, à vous la parole ! » : retours sur la session Infolab à l'assemblée générale du 21 mai.
Par Faustine Bougro le 28 mai 2013L'assemblée générale annuelle se tenait ce 21 mai à l'Échangeur PME. Cette matinée était l'occasion pour les adhérents de découvrir les projets actés et prospectifs, et en particulier la campagne menée par l'équipe Infolab !
Pour engager cette demi-journée, Fabienne Guibé et moi-même présentions la Campagne Infolab dans ses tenants et ses aboutissants. Deux temps successifs de plénière, « Adhérents, à vous la parole ! », s'en sont suivis. Les thèmes de réflexion explorés et les problématiques soulevées ont su esquisser de futurs champs d'action pour l'Infolab.
Retours sur ces contributions...
Lucié Dupré (Région Pays de la Loire) activa la discussion par la question du format des Infolabs sur le territoire : « On se tourne de plus en plus vers les lieux fixes, il peut parfois y avoir une sorte de piège ». L'idée d'une boîte à outils, en tant qu'agent régional de médiations à la donnée, entre les zones rurales et urbaines, a alors été introduite. Celle-ci se positionnerait en facilitatrice plutôt qu'en exploitante. Il s'agirait de repérer les besoins et les réseaux d'acteurs pour que la collectivité devienne une réelle ambassadrice de la méthodologie.
Effectivement, nous n'intervenons pas sur un terrain vierge, la ville vit déjà par elle-même et il est donc indispensable de s'ajuster à chaque contexte. L'entrée thématique s'est révélée de fait et tout au long du dialogue, plus impactante, notamment pour y introduire des associations, et aller donc là où les citoyens sont déjà mobilisés. Ces dernières se verraient alors porteuses d'une culture de la donnée.
C'est sur cette entrée par la collectivité, que Xavier Crouan (Région Île de France) a exposé l'exemple de la cartographie des subventions, qui démontra par la réalité des données l'inverse du discours politique. Par ses dérives, l'utilisation des données a soulevé la nécessaire question des libertés individuelles. Qui pourrait alors être le garant de nos données personnelles et collectives, une collectivité territoriale ?
L'éducation à la donnée, soulignée pas Sébastien Semeril (Élu Rennes Métropole) s'est, de fait, révélée une fois de plus primordiale. A ce titre, Rennes Métropole élabore un programme d'éducation numérique lors des activités périscolaires en CM1 et CM2.
Néanmoins, si l'on évoque beaucoup la pédagogie envers les citadins, les participants ont mis en lumière le fait que pour créer un terrain fertile à l'innovation urbaine ouverte, les acteurs publiques doivent eux-même être détenteurs d'un culture de la donnée. Il s'agirait d'équiper les élus afin de leur redonner une certaine autonomie.
Aussi, à une période de pragmatisme comptable, il est primordiale de réfléchir à la conception de services publiques sous l'angle de la co-conception. Nous nous devons d'être sensibilisés aux données que nous produisons et au fait que celles-ci peuvent contribuer à l'appréhension du territoire. L'exemple d'Handistar se révèle pertinent quant à sa possible application sur d'autres territoires.
Cette interrogation engagée sur le territoire a ouvert un champ d'action à l'Infolab inattendu et judicieux : « Comment peut s'appliquer l'infolab au sein d'une entreprise ? » questionne Aymeric Raoult (La Poste), tout en exposant la possible insertion d'experts de la donnée au sein de l'entreprise, pour une plus grande transversalité. Frédérique Pain (Alcatel) soumet alors l'idée « d'un pôle de compétitivité autour de la donnée ».
Ces nouvelles réalités ainsi mises en lumière promettent de réveiller le débat public et de décloisonner, stimuler les relations entre les entreprises, les acteurs du territoires et les citoyens. Merci à tous les participants pour leurs contributions riches d'enseignements qui sauront nourrir nos prochaines investigations !

Conception & réalisation : Facyla ~ Items International
Plateforme construite avec le framework opensource Elgg 1.8